Le fichier llms.txt est un fichier texte au format Markdown, placé à la racine d'un site, qui décrit le contenu du site aux modèles de langage et aux agents d'IA. Ce guide traite de ce que contient le fichier llms.txt, de ses lecteurs, des mesures publiées sur son utilité, de sa différence avec robots.txt et de son intérêt pour le référencement IA.
Qu'est-ce que le fichier llms.txt ?
Le fichier llms.txt est une proposition d'utiliser, à la racine d'un site, un fichier au format Markdown qui fournit aux agents d'IA les informations utiles pour exploiter ce site, selon la spécification publiée sur llmstxt.org.
Le fichier se rédige en Markdown, et son auteur le désigne comme une proposition de standardisation : ce guide reprend le mot « proposition » et n'en fait ni une norme ni un standard. La demande est d'environ 720 recherches par mois pour « llms.txt » (Google Ads, France, octobre 2026, mesure du 14 novembre 2026 ; les graphies « llms txt » et « llmstxt » y sont regroupées ; entre 590 et 1 000 sur douze mois).
Six questions précisent cette définition : le contenu du fichier et son emplacement, son usage, son origine, les définitions des sources, sa place dans le SEO et l'IA, sa rédaction.
Que contient le fichier llms.txt et où se place-t-il ?
Le fichier llms.txt contient un titre de niveau 1 obligatoire, puis des éléments facultatifs, dans un ordre fixé, et se place à la racine du site ou dans un sous-chemin, selon la spécification publiée sur llmstxt.org. Le fichier llms.txt compte cinq éléments, dans cet ordre.
- Dans le fichier llms.txt, une marque d'ordre des octets (BOM) facultative ouvre le fichier.
- Dans le fichier llms.txt, un titre de niveau 1 porte le nom du projet ou du site.
- Dans le fichier llms.txt, une citation Markdown résume le projet en quelques mots et donne les informations clés pour comprendre la suite.
- Dans le fichier llms.txt, zéro, une ou plusieurs sections Markdown, de tout type sauf des titres, détaillent le projet et la façon de lire les fichiers listés.
- Dans le fichier llms.txt, zéro, une ou plusieurs sections délimitées par des titres de niveau 2 contiennent des listes de fichiers : chaque entrée est un lien Markdown de la forme
[nom](url), suivi au besoin de deux-points et de notes.
Cet exemple fictif applique ces éléments dans un fichier court.
# Atelier Exemple

> Atelier Exemple fabrique des tables en bois sur mesure et publie des guides d'entretien.

## Guides
- [Entretenir une table en chêne](https://example.com/guides/chene): fréquence et produits
- [Choisir une huile de finition](https://example.com/guides/huile): comparaison des finitions

## Optional
- [Conditions de livraison](https://example.com/livraison)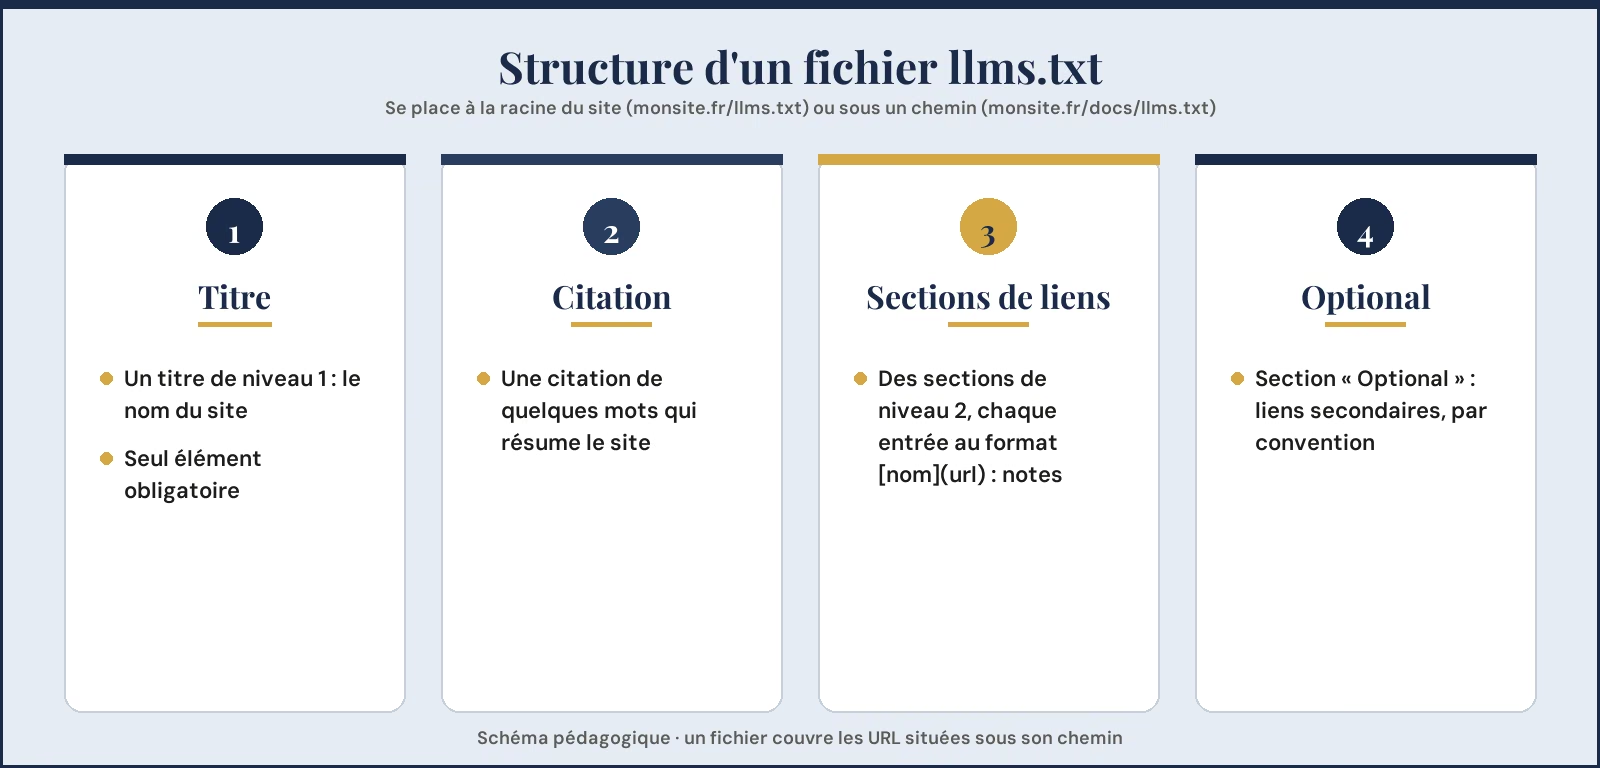
Par convention, la section « Optional » du fichier llms.txt rassemble des liens secondaires qu'un agent peut ignorer quand un contexte plus court est nécessaire, selon la spécification de llmstxt.org. Où le placer ? Le fichier se place à la racine du site, à l'adresse /llms.txt, ou à n'importe quel sous-chemin comme /docs/llms.txt : un fichier couvre les URL situées sous son chemin, et l'agent applique le plus spécifique quand plusieurs fichiers conviennent, selon la version 2 de la spécification. Reste à établir l'usage que la spécification prévoit pour ce contenu.
À quoi sert le fichier llms.txt ?
Le fichier llms.txt sert à fournir à un agent d'IA un aperçu choisi du site, lu à la demande quand l'agent a besoin d'informations sur un sujet, selon la spécification de llmstxt.org.
L'auteur de la proposition écrit qu'il s'attendait à une utilité surtout pour l'inférence plutôt que pour l'entraînement, que le fichier a été utilisé ainsi, tout en notant que des entraînements de modèles pourraient exploiter ces informations. Les sitemaps listent toutes les pages pour les moteurs de recherche, alors que le fichier llms.txt en propose un aperçu choisi, selon la section « Existing standards » de la même spécification. Le fichier se place à une adresse connue, que l'agent peut récupérer : la spécification écrit que les agents sont « expected » (attendus) de consulter ou de chercher dans le fichier les informations dont ils ont besoin, puis de suivre les liens pertinents, ce qui décrit l'intention de l'auteur et non le comportement mesuré d'un moteur. La proposition porte une date et un auteur.
Depuis quand existe le fichier llms.txt et qui l'a proposé ?
Le fichier llms.txt a été proposé le 3 septembre 2024 par Jeremy Howard, selon la page de la spécification sur llmstxt.org.
La page a été modifiée le 10 août 2026 et se présente comme la version 2 de la proposition. Son auteur y écrit que des milliers de sites publient un fichier llms.txt ; ce chiffre est déclaré par l'auteur, sans méthode de mesure sur la page. La spécification se présente comme une proposition et comme un aperçu informel, hébergé dans un dépôt GitHub et ouvert aux contributions de la communauté. La documentation de Mintlify, éditeur de plateforme de documentation, appelle le fichier « an industry standard » (un standard de l'industrie), alors que llmstxt.org parle de proposition : ces deux vocabulaires divergent, et ce guide ne tranche pas. Les sources ne s'accordent pas toutes sur le rôle du fichier.
Comment les sources définissent-elles le fichier llms.txt ?
Les sources ne donnent pas toutes le même rôle au fichier llms.txt.
Le tableau compare cinq sources, consultées le 14 novembre 2026, sur le rôle qu'elles donnent au fichier llms.txt, chacune avec sa date.
| Source | Ce que la source dit du fichier llms.txt | Date |
|---|---|---|
| llmstxt.org, « The /llms.txt file, v2 » | Une proposition d'utiliser un fichier /llms.txt pour fournir aux agents des informations qui les aident à utiliser un site | Publiée le 3 septembre 2024, modifiée le 10 août 2026 |
| Chrome for Developers, audit Lighthouse « llms.txt » | Une « convention émergente » qui fournit un résumé du contenu d'un site lisible par machine, conçu pour les LLM et les agents d'IA | Page mise à jour le 5 mai 2026 |
| Google Search Central, « Optimizing your website for generative AI features on Google Search » | La Recherche Google n'utilise pas les fichiers LLMS.txt : le guide écrit qu'elle les ignore | Guide mis à jour le 10 juillet 2026 |
| SeoMix, « Llms.txt : le fichier inutile pour le GEO et les IA » | Un fichier jugé inutile pour le GEO et les IA : le titre de l'article le dit, et l'article s'appuie sur une analyse de journaux de serveur | Page mise à jour le 16 juin 2026 |
| Vu du web | Un fichier dont l'objectif principal est de « définir quelles pages de votre site ces IA peuvent consulter, indexer ou utiliser » | Date affichée du 10 février 2025 |
Ce guide suit la spécification de llmstxt.org, qui décrit le fichier llms.txt comme un aperçu choisi, consulté à la demande, et distingue ce rôle de celui de robots.txt, qui règle l'accès (section « Existing standards »). La lecture de Vu du web, un contrôle d'accès, diverge de ce texte. Le SEO et l'IA donnent à ce fichier son cadre.
Où le fichier llms.txt se situe-t-il dans le SEO et l'IA ?
Le fichier llms.txt relève de la partie technique du SEO IA : c'est un contenu que le site publie, à distinguer des réglages d'accès, selon notre lecture.
Le fichier llms.txt s'adresse aux modèles de langage et aux agents d'IA, alors que le GEO et l'AEO, deux des trois noms du SEO IA, visent la visibilité dans les réponses que ces moteurs rédigent. Le guide sur GEO, AEO et visibilité traite les trois noms du SEO IA, GEO, AEO et LLMO, et la mesure de la visibilité dans les réponses des IA. Le guide d'optimisation de Google pour l'IA, mis à jour le 10 juillet 2026, cite parmi les tactiques que l'on peut ignorer pour Google Search « creating unnecessary AI text files (like llms.txt) » (créer des fichiers texte d'IA inutiles, comme llms.txt), sous le conseil de privilégier les stratégies SEO efficaces plutôt que les « AEO/GEO hacks ». Le fichier llms.txt se rédige selon l'ordre de la spécification.
Comment rédiger un fichier llms.txt ?
Rédiger un fichier llms.txt commence par le nom du site en titre de niveau 1, avant la citation et les listes de liens en Markdown, selon la spécification de llmstxt.org.
La rédaction suit quatre étapes, dans l'ordre de la spécification.
- Dans le fichier llms.txt, écrire le nom du site en titre de niveau 1.
- Dans le fichier llms.txt, rédiger la citation de résumé en une ou deux phrases.
- Dans le fichier llms.txt, lister les pages clés en liens sous des titres de niveau 2, chaque ligne reprenant le modèle
[nom](url) : notes. - Dans le fichier llms.txt, réserver à la section « Optional » les liens secondaires.
Le fichier se publie à l'adresse /llms.txt, qui répond sans erreur de serveur, puisque l'audit Lighthouse de Chrome signale une erreur de serveur à la récupération du fichier. Notre vérification pratique, qui ne vient pas de llmstxt.org : l'adresse répond en statut 200, en texte brut. Pour tester le contenu, llmstxt.org suggère de poser à un agent des questions sur le site en ne lui donnant que le fichier llms.txt comme point de départ. Peut-on le générer automatiquement ? Oui : la liste « Integrations » de llmstxt.org nomme cinq plateformes, avec le verbe de chacune. Yoast SEO, une extension WordPress, génère et maintient le fichier ; AIOSEO, une extension WordPress, propose un générateur de llms.txt ; Wix le génère pour chaque site Wix ; GitBook le sert pour les sites de documentation publiés ; Mintlify le génère pour chaque site qu'il héberge. Ce guide ne classe ni ne recommande aucune de ces plateformes. Les robots et les services d'IA constituent les lecteurs visés par ce fichier.
Quels robots et services d'IA lisent vraiment le fichier llms.txt ?
Les acteurs n'entretiennent pas la même relation au fichier llms.txt : la Recherche Google l'ignore, l'audit Lighthouse de Chrome le vérifie, et plusieurs éditeurs d'IA publient le leur.
Dans ce guide, lire le fichier llms.txt signifie qu'un robot ou un outil le demande au serveur, ce que montre une ligne de journal, et non qu'une IA s'en sert pour répondre : c'est notre définition. Trois sources donnent trois relations, en commençant par celle de Google.
Que dit Google du fichier llms.txt ?
Google dit du fichier llms.txt que la Recherche Google ne l'utilise pas, selon son guide « Optimizing your website for generative AI features on Google Search », mis à jour le 10 juillet 2026.
Dans sa section « Mythbusting generative AI search: what you don't need to do », le guide écrit qu'il n'est pas nécessaire de créer de nouveaux fichiers lisibles par machine, fichiers texte d'IA, balisage ou Markdown pour apparaître dans la Recherche Google, fonctionnalités d'IA générative comprises, car la Recherche Google elle-même ne les utilise pas. Il ajoute qu'en créer ne nuit ni n'aide à la visibilité ou au classement dans la Recherche Google, qui les ignore, et qu'il est « completely fine » (tout à fait acceptable) de créer et de maintenir des fichiers LLMS.txt pour d'autres services ou systèmes qui les utilisent. La portée du guide est la Recherche Google ; il ne dit rien d'un autre service. Google l'utilise-t-il pour les AI Overviews et le Mode IA ? Non : le guide présente ses bonnes pratiques pour les fonctionnalités d'IA générative de Google Search, « such as AI Overviews and AI Mode » (comme les AI Overviews et le Mode IA), mais sa phrase sur llms.txt ne nomme aucune des deux ; que ni l'une ni l'autre n'utilise le fichier est notre lecture. La version française de la page affiche le 13 juillet 2026 comme date de mise à jour. Google écrit que ses fonctionnalités d'IA générative dans Google Search reposent sur ses systèmes centraux de classement et de qualité de la Recherche, de sorte que « the best practices for SEO continue to be relevant » (les bonnes pratiques SEO restent pertinentes) ; la base de visibilité dans ces fonctionnalités est donc le travail SEO qui sert le reste de la Recherche Google, notre lecture. Comme le rapporte Search Engine Journal le 2 juin 2026, John Mueller, de Google, a écrit dans un commentaire Reddit : « I don't think anyone knows – it's purely speculative for now (the file has existed for years, yet none of the AI systems use it — what does it mean?) ». Le commentaire Reddit est relayé par Search Engine Journal et nous ne l'avons pas lu ; c'est une remarque personnelle, non une documentation de Google. Chrome traite le fichier llms.txt comme un objet à vérifier.
Que vérifie l'audit Lighthouse sur le fichier llms.txt ?
L'audit Lighthouse signale une erreur de serveur quand le fichier llms.txt est demandé, et classe l'absence du fichier (404) « Not Applicable », car fournir le fichier est facultatif pour le moment, selon Chrome for Developers.
La page de Chrome for Developers, mise à jour le 5 mai 2026, range l'audit dans le groupe « Agentic browsing audits » et décrit le fichier comme une « convention émergente » qui fournit un résumé du contenu d'un site lisible par machine, conçu pour les LLM et les agents d'IA. Cet audit mesure si le fichier se récupère, notre lecture : il n'indique aucun gain dans la recherche ni dans les réponses d'IA, et il relève d'un outil pour développeurs, non d'une déclaration de la Recherche Google. Les éditeurs d'IA publient leur propre fichier llms.txt.
Quels éditeurs d'IA publient eux-mêmes un fichier llms.txt ?
OpenAI, Anthropic, Perplexity et Google (pour Gemini API et AI Studio) publient chacun un fichier llms.txt qui indexe leur documentation pour développeurs, constat fait le 14 novembre 2026 sur leurs adresses.
Les adresses sont developers.openai.com/llms.txt, platform.claude.com/llms.txt, docs.perplexity.ai/llms.txt et aistudio.google.com/llms.txt, que l'adresse ai.google.dev/gemini-api/docs/llms.txt atteint par une redirection 301 ; cette redirection, comme la réponse 200 en texte brut des quatre autres adresses, a été mesurée le 15 novembre 2026, alors que les quatre fichiers eux-mêmes ont été récupérés le 14 novembre 2026. La spécification v2 cite OpenAI, Anthropic et Gemini parmi les laboratoires qui publient leurs fichiers pour leur documentation. Les quatre fichiers indexent de la documentation pour développeurs, et celui d'Anthropic ne suit le format qu'en partie : un paragraphe remplace la citation, et les notes suivent un tiret au lieu des deux-points. Le fichier de Perplexity se trouve sur un site de documentation hébergé sur la plateforme Mintlify, d'après la configuration de documentation lue dans la page de Perplexity ; ce guide n'en tire aucune intention, notre lecture. Publier son propre fichier n'est pas lire ceux des autres sites, et aucun de ces fichiers n'indique que son éditeur lit des fichiers tiers, notre lecture.
Que montrent les données sur l'utilité réelle du fichier llms.txt ?
Les données publiées montrent très peu de lectures du fichier llms.txt : aucun appel de robot d'IA sur 60 jours chez SeoMix, 10 requêtes de robots d'IA identifiés sur 1 657 chez Abondance.
Les chiffres viennent de deux journaux de serveur publiés en 2026 : celui d'Abondance, dans son article « Fichier llms.txt : ChatGPT ne l'a ouvert que 2 fois en 5 mois sur Abondance », publié le 5 novembre 2026, et celui de SeoMix, dans son article « Llms.txt : le fichier inutile pour le GEO et les IA », mis à jour le 16 juin 2026. Le tableau compare les deux mesures par période, durée, échantillon, comptage, résultat et réserve.
| Mesure | SeoMix | Abondance |
|---|---|---|
| Période | Avril et mai 2026 | Du 1er juin au 4 novembre 2026 |
| Durée | 60 jours d'analyse | 156 jours de journaux (ceux du 22 octobre manquent) |
| Échantillon | Les journaux de 6 sites de l'agence | Un seul site, abondance.com |
| Ce qui est compté | 33 092 passages de robots d'IA sur 2 249 URL | 1 657 requêtes sur /llms.txt et /llms-full.txt |
| Requêtes sur le fichier par des robots d'IA identifiés | Aucun appel | 10, soit 0,6 %, dans une catégorie « robots d'IA » qui inclut Common Crawl ; détail donné par Abondance : ChatGPT-User 2, ClaudeBot 2 (une seule ouverture, le 21 octobre), Meta-ExternalAgent 4 ; le reste de la catégorie n'est pas détaillé |
| Réserve | Un seul éditeur ; « aucun appel » vaut pour les robots d'IA que SeoMix a identifiés ; la page ne dit pas si chacun des 6 sites publiait un fichier | Un seul site ; une requête ne prouve pas l'usage, donc ces chiffres sont des plafonds ; GPTBot, bloqué par le pare-feu de l'hébergeur du 25 août au 5 novembre, et PerplexityBot, bloqué en partie, affichent 0, à lire avec cette limite |
Abondance signale un blocage pour GPTBot et pour PerplexityBot seulement ; OAI-SearchBot affiche 0 requête sans blocage signalé. Dans les mêmes journaux, Abondance attribue 585 requêtes (35,3 %) à des outils SEO, GEO et scanners et 34 requêtes au vrai Googlebot.
Sur les 137 210 domaines d'Ahrefs Web Analytics ayant reçu du trafic en mai 2026, 28 % publient un fichier llms.txt et, parmi les quelque 38 000 domaines disposant d'un fichier valide, 97 % n'ont reçu aucune requête pour ce fichier ce mois-là, selon l'étude « We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read » d'Ahrefs (page du 15 juin 2026). Le chiffre de 28 % est une borne haute : selon Ahrefs, ses clients Web Analytics penchent plus vers le technique et le SEO que le web dans son ensemble, et les 19,5 % de requêtes venues d'outils d'IA nommés portent sur les 3 % de fichiers lus, non sur les 137 K domaines, selon la même étude. Ahrefs vend des outils SEO, et une requête n'est pas une lecture : chaque chiffre est un plafond.
SE Ranking indique, dans son étude du 15 octobre 2026, que 10,13 % de près de 300 000 domaines avaient un fichier llms.txt ; ce taux ne se compare pas à celui d'Ahrefs, car les jeux de données diffèrent, notre lecture.
Semrush, dans son analyse de journaux de son site frère Search Engine Land (article du 28 septembre 2026), ne relève aucune visite de GPTBot, de ClaudeBot ni de PerplexityBot sur la page llms.txt de la mi-août à fin octobre 2025 ; Googlebot et Bingbot l'ont récupérée seulement quelques fois, ce que Semrush interprète comme l'absence d'importance particulière.
Adobe Experience League, dans son tutoriel vidéo « LLMs.txt - is it relevant (June 2026) » (page mise à jour le 8 novembre 2026), rapporte l'audit des journaux de 4 685 sites hébergés sur AEM : 0,4 % avaient un fichier llms.txt. Selon la vidéo, dont les chiffres viennent de sous-titres automatiques, 92 % d'environ 22 000 requêtes de robots vers ces fichiers sur 30 jours venaient d'outils SEO, 6,4 % de Googlebot et 1,1 % de robots de LLM, et Googlebot a fait 1 219 requêtes. Ces deux chiffres ne coïncident pas exactement : 6,4 % d'environ 22 000 requêtes font environ 1 400, non 1 219, et nous reportons les deux comme ceux d'Adobe, notre lecture. Adobe dit que Googlebot lit désormais (récupère) le fichier et qu'elle ne peut pas affirmer que Google l'utilise. Pour Semrush comme pour Adobe, une récupération par Googlebot n'est pas un usage, notre lecture.
Ces mesures viennent de six éditeurs, SeoMix, Abondance, Ahrefs, SE Ranking, Semrush et Adobe ; elles ne montrent pas qu'aucun service d'IA ne lit un fichier llms.txt ailleurs, notre lecture. Pour le SEO et le GEO, aucune des sources consultées ne chiffre un gain de visibilité lié au fichier llms.txt, notre lecture au 14 novembre 2026. La lecture du fichier se mesure dans les journaux du serveur.
Comment mesurer si les IA lisent son fichier llms.txt ?
Pour savoir si des IA lisent son fichier llms.txt, on compte, dans les journaux d'accès du serveur ou du CDN, les requêtes sur /llms.txt par user-agent, sur une période datée, notre lecture de la méthode des études publiées.
Abondance a compté les requêtes sur ses deux fichiers sur toute la période de ses journaux et identifié les robots par leur nom ; SeoMix a filtré les journaux de ses sites sur les robots de LLM connus, validé ces robots, puis vérifié les requêtes sur l'URL du fichier. La mesure suit trois étapes.
- Pour le fichier llms.txt, récupérer les journaux d'accès bruts d'une période datée.
- Pour le fichier llms.txt, filtrer le chemin /llms.txt, et /llms-full.txt s'il existe.
- Pour le fichier llms.txt, regrouper les requêtes par user-agent et séparer les robots d'IA, les outils SEO et les robots des moteurs de recherche.
Un pare-feu ou un blocage change ce qui est compté : chez Abondance, GPTBot est resté bloqué à partir du 25 août et PerplexityBot en partie, et les chiffres de ces deux robots sont des plafonds. La documentation de Google décrit une recherche DNS inversée puis directe pour vérifier une requête qui se dit venue de Google : une chaîne user-agent seule ne prouve donc pas qui a envoyé la requête, notre lecture. Le gain d'un site qui publie le fichier se juge sur ces mesures.
Que gagne un site qui publie un fichier llms.txt ?
Aucune des sources consultées ne chiffre de gain de visibilité, de trafic ou de citation lié au fichier llms.txt, notre lecture des sources de ce guide au 14 novembre 2026.
SeoMix (page du 16 juin 2026) et Abondance (page du 5 novembre 2026) comptent des lectures, non des gains, et Google écrit que, pour la Recherche Google, le fichier n'aide ni ne nuit à la visibilité. SE Ranking, éditeur d'outils de suivi de la visibilité IA, ne trouve aucune corrélation entre la présence d'un fichier llms.txt et la fréquence de citation d'un domaine par les LLM, sur près de 300 000 domaines, dans l'étude « Does LLMs.txt impact your AI visibility and citations? No, according to research » (page du 15 octobre 2026). C'est une corrélation, non une cause, et la page ne donne pas la période des données. Les analyses de Semrush, d'Ahrefs et d'Adobe comptent des requêtes sur des fichiers, non un gain ; l'absence de gain est notre lecture des pages de SE Ranking, Semrush, Ahrefs et Adobe lues le 14 novembre 2026. Pour un agent qui le lit, le fichier reste une entrée choisie : la spécification attend des agents qu'ils consultent ou cherchent dans le fichier llms.txt les informations dont ils ont besoin, puis suivent les liens pertinents, sans annoncer d'effet. Reste à savoir si le fichier fait citer une page.
Un fichier llms.txt fait-il citer une page par les IA ?
Aucune source consultée ne montre qu'un fichier llms.txt fasse citer une page par une IA, notre lecture au 14 novembre 2026.
L'étude de SE Ranking relie la présence du fichier à la fréquence de citation et n'y trouve aucun lien statistique, mais elle mesure une corrélation, non une cause, et vient d'un éditeur d'outils. La documentation des robots d'OpenAI, d'Anthropic, de Perplexity et de Google, consultée le 14 novembre 2026, ne mentionne pas le fichier llms.txt comme un fichier lu par un robot ; OpenAI et Perplexity ne citent son nom que dans la bannière de leur propre index de documentation. Un moteur d'IA choisit-il ses sources d'après ce fichier ? La sélection des sources propre à chaque moteur relève des guides consacrés à ces moteurs, comme les AI Overviews et le Mode IA de Google, et la différence entre être classé et être cité relève du guide SEO vs GEO. Reste à situer le fichier face à robots.txt.
Quelle différence entre le fichier llms.txt et le fichier robots.txt ?
Le fichier robots.txt indique aux robots ce qu'ils peuvent explorer, alors que le fichier llms.txt ne donne aucune consigne d'accès : il propose une liste choisie de pages à lire.
Google Search Central décrit le fichier robots.txt comme un fichier qui indique aux robots d'exploration des moteurs de recherche les URL qu'ils peuvent explorer sur le site (« Introduction to robots.txt »). La spécification de llmstxt.org écrit que le fichier llms.txt peut compléter robots.txt en apportant du contexte sur le contenu autorisé, les deux fichiers ayant des objectifs différents (section « Existing standards »). Vu du web présente le fichier llms.txt comme un contrôle d'accès, ce que la spécification ne fait pas : elle le dit conçu pour coexister avec les standards actuels du web. Le tableau compare quatre fichiers par fonction : ce qu'il fait, qui le lit et ce qu'il impose.
| Fichier | Ce qu'il fait | Qui le lit | Ce qu'il impose |
|---|---|---|---|
| robots.txt | Indique aux robots d'exploration des moteurs de recherche les URL qu'ils peuvent explorer sur le site | Les robots d'exploration des moteurs de recherche | L'accès : les URL explorables ou non |
| sitemap.xml | Fournit des informations sur les pages, vidéos et autres fichiers du site et indique les pages que le site juge importantes | Les moteurs de recherche, pour explorer le site plus efficacement | Une liste de pages jugées importantes, sans règle d'accès dans la description de Google |
| llms.txt | Propose aux agents d'IA un aperçu choisi du site, utilisé à la demande | Les modèles de langage et les agents d'IA, quand ils ont besoin d'informations sur un sujet | Aucune directive d'accès dans la spécification v2 |
| llms-full.txt | Regroupe toute la documentation d'un site en un seul fichier, généré par des plateformes de documentation comme Mintlify, hors de la spécification de llmstxt.org | Les outils d'IA et l'indexation par LLM, selon Mintlify ; Anthropic en référence un dans son fichier llms.txt | Aucune règle : la spécification ne le mentionne pas |
Quatre questions précisent ce contraste : l'interdiction d'usage, les robots d'IA à autoriser, l'ordre de travail et l'avenir du fichier.
Le fichier llms.txt permet-il d'empêcher une IA d'utiliser ses pages ?
Non, le fichier llms.txt ne permet pas d'empêcher une IA d'utiliser ses pages : la spécification v2 ne prévoit aucune directive d'autorisation ou d'interdiction.
L'accès des robots d'exploration se règle dans robots.txt, selon Google Search Central (« Introduction to robots.txt »). Pour les fonctionnalités d'IA générative de Google, le contrôle se trouve dans la Search Console : selon l'aide de la Search Console, le réglage « Search generative AI control » (Settings > Search generative AI) a pour valeur par défaut « Include my site's links and content in Search generative AI features » (inclure les liens et contenus du site), et une propriété qui a une propriété parente prend par défaut « Inherit control from parent » (hériter du contrôle de la propriété parente).
Quels robots d'IA faut-il autoriser dans robots.txt en plus du fichier llms.txt ?
Le fichier llms.txt n'autorise aucun robot : les robots d'exploration d'IA se règlent par leur jeton dans robots.txt, que le fichier llms.txt soit publié ou non.
Les pages de documentation d'OpenAI, d'Anthropic, de Perplexity et de Google, consultées le 14 novembre 2026, documentent plusieurs jetons d'IA, parmi lesquels ces neuf : OAI-SearchBot, GPTBot, ChatGPT-User, ClaudeBot, Claude-User, Claude-SearchBot, PerplexityBot, Perplexity-User et Google-Extended. OpenAI règle OAI-SearchBot et GPTBot par robots.txt, avec des réglages indépendants, selon sa page « Overview of OpenAI Crawlers » ; Anthropic écrit que ses robots ClaudeBot, Claude-User et Claude-SearchBot respectent les directives de robots.txt et que, depuis le 30 octobre 2026, Anthropic reconnaît un signal lisible par machine qui permet à un site d'exprimer sa préférence sur l'usage de ses contenus pour entraîner des modèles d'IA, un contrôle distinct de robots.txt ; Perplexity donne une balise robots.txt pour PerplexityBot ; Google présente Google-Extended comme un jeton autonome pour Gemini, sans effet sur Google Search. Deux agents lancés par un utilisateur font exception, selon leurs éditeurs : pour ChatGPT-User, « robots.txt rules may not apply » (OpenAI), et Perplexity-User « generally ignores robots.txt rules » (Perplexity). La liste des robots d'IA est tenue dans le guide SEO et IA.
Par quoi commencer : robots.txt ou llms.txt ?
Commencer par robots.txt : il règle l'accès des robots, alors que le fichier llms.txt ne règle aucun accès et n'a aucun lecteur établi dans la Recherche Google, notre lecture de leurs rôles.
Les rôles viennent de Google Search Central pour robots.txt et de llmstxt.org pour le fichier llms.txt. La Recherche Google n'utilise pas le fichier llms.txt, d'après son guide sur les fonctionnalités d'IA générative. L'avenir du fichier comme standard est une autre question que son rôle actuel.
Le fichier llms.txt va-t-il devenir un standard ou remplacer robots.txt ?
Non : la spécification de llmstxt.org ne présente le fichier llms.txt ni comme un standard acquis ni comme un remplaçant de robots.txt, mais comme une proposition conçue pour coexister avec les standards du web.
Aucune source consultée n'annonce son adoption comme standard, notre lecture ; l'avenir du fichier n'est documenté dans aucune d'elles, et ce guide n'avance aucune prévision. La priorité que mérite le fichier en GEO se juge sur l'ensemble de ces constats.
Le fichier llms.txt est-il une priorité GEO ?
Non, selon notre lecture des mesures publiées, le fichier llms.txt n'est pas une priorité GEO : peu de lectures, aucun gain chiffré parmi les sources consultées.
Publier un fichier llms.txt coûte peu : la réponse est donc « pas prioritaire », non « interdit » ni « inutile pour tous », car les mesures ne disent pas cela. Quatre questions précisent cette décision : la place du fichier dans le SEO ou le GEO, les conditions de Google, les sites qui publient un fichier et le moment de confier le sujet à une agence.
Le fichier llms.txt relève-t-il du SEO ou du GEO ?
Le fichier llms.txt relève du SEO IA, dont le GEO est l'un des noms, par son lecteur visé, les modèles de langage et les agents d'IA, mais il n'a aucune fonction de classement dans la Recherche Google, notre lecture.
La Recherche Google n'utilise pas ces fichiers, écrit Google Search Central dans son guide sur les fonctionnalités d'IA générative. Quel rapport avec le GEO et le LLMO ? Le GEO, l'AEO et le LLMO sont un même travail vu sous trois angles dans la lecture du site : moteur génératif, moteur de réponse, modèle de langage. La comparaison du SEO et du GEO, avec ses différences, points communs et priorités, a son propre guide, et ce guide ne détaille pas cette comparaison.
Le fichier llms.txt fait-il partie des conditions pour apparaître dans les moteurs d'IA de Google ?
Non, le fichier llms.txt ne fait pas partie des conditions pour apparaître dans les AI Overviews et le Mode IA de Google, notre lecture de la liste de conditions du guide du 10 juillet 2026.
Une page n'apparaît comme lien d'appui dans les AI Overviews et le Mode IA que si trois conditions sont réunies : elle est indexée, elle peut s'afficher dans Google Search avec un extrait, et son site est inclus dans « Search generative AI features » (en français « Contrôle de l'IA générative dans la Recherche ») dans la Search Console. Le guide sur les AI Overviews de Google détaille ces conditions et ce qu'une page fait pour y être citée. Savoir quels sites doivent publier le fichier est une question distincte de ces conditions.
Qui doit publier un fichier llms.txt ?
Les sites qui publient une documentation pour développeurs devraient publier un fichier llms.txt, à notre lecture, comme OpenAI, Anthropic, Perplexity et Google le font pour leur documentation.
Trois cas montrent cette décision ; ils sont notre lecture, sans source externe.
- Pour un site de documentation, le fichier llms.txt peut lister les pages de ses guides à l'intention des agents ; le coût est une courte liste de liens à entretenir, et la réserve est que la publication ne montre aucun lecteur.
- Pour une boutique en ligne, le fichier llms.txt peut lister ses pages de catégories et de conditions à l'intention des agents ; le coût est un fichier Markdown tenu à jour avec le catalogue, et la réserve est un catalogue qui change souvent.
- Pour le site d'une agence ou d'un éditeur, le fichier llms.txt peut lister ses guides et ses services ; le coût est l'entretien de la liste, et la réserve est qu'aucune source vérifiée ne montre un changement de citations ni de trafic.
Pour trancher entre ces cas quand le site a plus de corrections possibles que de temps, un consultant SEO conseille sur les priorités, tandis que l'équipe du site ou une agence exécute le travail, notre lecture.
Quand confier le fichier llms.txt à une agence GEO ?
Publier un fichier llms.txt ne demande pas d'agence ; confier son référencement IA à une agence GEO se justifie quand l'enjeu est de mesurer et d'améliorer la visibilité dans les réponses des IA, pas de publier un fichier.
Cette réponse est notre lecture, sans source externe. Une agence GEO suit la visibilité d'un site dans les réponses des IA, en mesure l'évolution et en ajuste les contenus ; confier ce travail revient à lui transférer ce suivi et ces ajustements. Le guide de l'agence GEO explique comment comprendre et confier son référencement IA, avec ce que couvre la prestation.